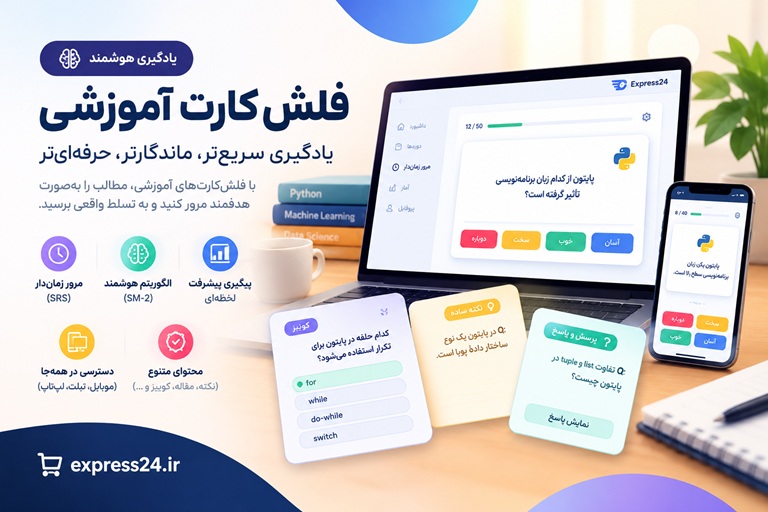
فلشکارتهای آموزشی کنترل بهینه سیستمهای خطی با یادگیری تقویتی: رهیافتهای فرم بسته با ترکیب LQR و MDP خطی
کنترل بهینه سیستمهای خطی با یادگیری تقویتی: تحولی نو در سیستمهای کنترل هوشمند کنترل بهینه سیستمهای خطی با یادگیری تقویتی: رهیافتهای فرم بسته با ترکیب LQR و MDP خطی آیا به دنبال راهی برای کنترل هوش...
🎓 دوره آموزشی جامع
📚 اطلاعات دوره
عنوان دوره: دوره کنترل بهینه سیستمهای خطی با یادگیری تقویتی: رهیافتهای فرم بسته با ترکیب LQR و MDP خطی
موضوع کلی: سیستمهای کنترل هوشمند
موضوع میانی: یادگیری تقویتی برای سیستمهای کنترل
📋 سرفصلهای دوره
- 1. مقدمهای بر سیستمهای کنترل هوشمند
- 2. تاریخچه و تکامل تئوری کنترل
- 3. مبانی سیستمهای دینامیکی خطی
- 4. نمایش فضای حالت (State-Space Representation)
- 5. مفهوم پایداری در سیستمهای کنترل
- 6. پایداری به مفهوم لیاپونوف
- 7. کنترلپذیری (Controllability) و رویتپذیری (Observability)
- 8. مروری بر جبر خطی: فضاهای برداری و ماتریسها
- 9. مقادیر ویژه، بردارهای ویژه و تاثیر آنها بر دینامیک سیستم
- 10. ماتریسهای معین مثبت و کاربرد آنها در کنترل
- 11. مقدمهای بر بهینهسازی و توابع هزینه
- 12. کنترل بهینه چیست؟
- 13. تنظیمکننده خطی درجه دوم (LQR): معرفی مساله
- 14. تابع هزینه درجه دوم در سیستمهای کنترل
- 15. اصل بهینگی بلمن (Bellman's Principle of Optimality)
- 16. برنامهریزی پویا (Dynamic Programming) برای مسائل کنترل
- 17. معادله ریکاتی جبری (Algebraic Riccati Equation - ARE)
- 18. حل معادله ریکاتی و یافتن بهره کنترل بهینه
- 19. کنترلکننده فیدبک حالت خطی (Linear State-Feedback)
- 20. ویژگیهای حلقه بسته سیستم تحت کنترل LQR
- 21. مقدمهای بر یادگیری تقویتی (Reinforcement Learning)
- 22. عامل، محیط، حالت، عمل و پاداش
- 23. فرآیندهای تصمیمگیری مارکوف (MDPs)
- 24. ویژگی مارکوف و دینامیک انتقال حالت
- 25. سیاست (Policy): قطعی و تصادفی
- 26. تابع ارزش حالت (V-function)
- 27. تابع ارزش عمل (Q-function)
- 28. معادلات بلمن برای توابع ارزش
- 29. معادلات بهینگی بلمن
- 30. الگوریتمهای برنامهریزی پویا در یادگیری تقویتی
- 31. الگوریتم تکرار سیاست (Policy Iteration)
- 32. الگوریتم تکرار ارزش (Value Iteration)
- 33. یادگیری بدون مدل (Model-Free Learning)
- 34. یادگیری مونت کارلو (Monte Carlo Methods)
- 35. یادگیری با تفاوت زمانی (Temporal-Difference Learning)
- 36. الگوریتم Q-Learning
- 37. الگوریتم SARSA
- 38. تقریب توابع در یادگیری تقویتی
- 39. چالشهای یادگیری تقویتی در فضاهای پیوسته
- 40. پیوند میان کنترل بهینه و یادگیری تقویتی
- 41. فرمولهبندی مساله LQR به عنوان یک فرآیند تصمیمگیری مارکوف
- 42. تعریف حالت، عمل و پاداش برای مساله LQR
- 43. MDP های خطی (Linear MDPs): تعریف و ویژگیها
- 44. تابع پاداش درجه دوم در چارچوب MDP
- 45. تابع ارزش درجه دوم در سیستمهای خطی
- 46. نمایش پارامتریک تابع Q برای سیستمهای خطی-درجه دوم
- 47. معادله بلمن برای مساله LQR
- 48. تکرار سیاست برای حل مساله LQR (با مدل مشخص)
- 49. تکرار ارزش برای حل مساله LQR (با مدل مشخص)
- 50. چالش اصلی: یادگیری کنترل بهینه بدون اطلاع از دینامیک سیستم
- 51. یادگیری تقویتی مبتنی بر مدل (Model-Based RL) برای کنترل
- 52. یادگیری تقویتی بدون مدل (Model-Free RL) برای کنترل
- 53. مفهوم یادگیری خارج از سیاست (Off-Policy) و درون سیاست (On-Policy)
- 54. جمعآوری داده از سیستم: اکتشاف در فضای عمل پیوسته
- 55. الگوریتمهای گرادیان سیاست (Policy Gradient Methods)
- 56. الگوریتمهای بازیگر-منتقد (Actor-Critic Methods)
- 57. یادگیری Q با استفاده از روش حداقل مربعات تفاوت زمانی (LSTD-Q)
- 58. فرمولهبندی مساله یادگیری Q به عنوان یک مساله رگرسیون
- 59. ساختار ماتریسی الگوریتم LSTD-Q
- 60. نمایش تابع Q به صورت پارامتریک: Q(x,u) = [x', u']' H [x; u]
- 61. استخراج پارامترهای ماتریس H از دادهها
- 62. راه حل فرم بسته برای تخمین پارامترهای تابع Q
- 63. ارتباط میان ماتریس H و راه حل معادله ریکاتی
- 64. از تابع Q به سیاست بهینه: استخراج بهره کنترل K
- 65. استخراج فرم بسته سیاست بهینه از تابع Q تخمینزده شده
- 66. تحلیل ریاضی استخراج سیاست بهینه
- 67. اثبات همگرایی سیاست یادگرفتهشده به سیاست LQR بهینه
- 68. الگوریتم یادگیری تقویتی دستهای (Batch RL) برای LQR
- 69. گام اول: جمعآوری دادههای حالت، عمل و پاداش
- 70. گام دوم: حل مساله حداقل مربعات برای یافتن پارامترهای Q
- 71. گام سوم: محاسبه بهره کنترل بهینه به صورت فرم بسته
- 72. تحلیل پایداری کنترلکننده یادگرفتهشده
- 73. شرایط لازم برای دادههای اکتشافی (Persistency of Excitation)
- 74. نقش نویز در تحریک سیستم و بهبود یادگیری
- 75. مقایسه روش فرم بسته با روشهای تکراری
- 76. پیادهسازی عملی: شبیهسازی یک سیستم خطی ساده
- 77. کنترل پاندول معکوس با استفاده از RL فرم بسته
- 78. تحلیل حساسیت الگوریتم به نویز اندازهگیری
- 79. تحلیل پیچیدگی محاسباتی و نیاز به داده (Sample Complexity)
- 80. یادگیری آنلاین در مقابل یادگیری دستهای برای سیستمهای کنترل
- 81. تطبیقپذیری الگوریتم با تغییرات دینامیک سیستم
- 82. تعمیم به سیستمهای خطی متغیر با زمان (LTV)
- 83. کنترل مقاوم با استفاده از یادگیری تقویتی
- 84. یادگیری توابع هزینه نامشخص (Inverse Reinforcement Learning)
- 85. ترکیب شناسایی سیستم (System Identification) با یادگیری تقویتی
- 86. مقایسه رویکرد شناسایی-سپس-کنترل با رویکرد RL مستقیم
- 87. یادگیری تقویتی برای سیستمهای با دینامیک تصادفی (Stochastic Linear Systems)
- 88. گسترش به مسائل ردیابی (Tracking) در کنترل
- 89. مدلسازی عدم قطعیت در یادگیری تقویتی
- 90. یادگیری تقویتی امن (Safe Reinforcement Learning)
- 91. کاربرد در رباتیک: کنترل حرکت بازوی ربات
- 92. کاربرد در وسایل نقلیه خودران: کنترل مسیر
- 93. کاربرد در مدیریت انرژی و شبکههای هوشمند
- 94. محدودیتهای رویکرد MDP خطی
- 95. چالشهای پیادهسازی روی سختافزار واقعی
- 96. مروری بر مقالات و تحقیقات مرتبط جدید
- 97. زمینههای تحقیقاتی باز در تلاقی کنترل و یادگیری تقویتی
- 98. جمعبندی نهایی دوره و مرور مفاهیم کلیدی
- 99. پروژه نهایی: طراحی و شبیهسازی یک کنترلکننده هوشمند برای یک سیستم خطی
SMART LEARNING PLATFORM
از مطالعه تا یادگیری ماندگار
فراتر از یک مجموعه فلشکارت؛ تجربهای تعاملی برای یادگیری، تمرین، مرور هوشمند و مشاهده مسیر پیشرفت شما، همراه با امکان دریافت گواهی پایان دوره در دورههای واجد شرایط.
مرور فاصلهدار
آمار یادگیری
گواهی دوزبانه
یادگیری را به یک مسیر قابل پیگیری تبدیل کنید
با ورود به سامانه آموزشی، محتوای دوره را بهصورت مرحلهای دنبال کنید، فلشکارتها را مرور کنید، دانش خود را با پرسشها و آزمونها بسنجید و روند پیشرفتتان را در طول مسیر ببینید.
⟳
مرور فاصلهدار هوشمند
با مرور زماندار، کارتهای تازه و کارتهای سررسیدشده را بر اساس برنامه مرور دنبال کنید. ارزیابی پاسخها به زمانبندی مرورهای بعدی کمک میکند تا تمرین متناسبتری داشته باشید.
◉
مشاهده مسیر پیشرفت
میزان مشاهده فلشکارتها، فعالیتهای مرور، عملکرد آزمونها و آمار یادگیری را بررسی کنید و تصویر روشنتری از مسیر آموزشی خود داشته باشید.
▤
یادگیری مرحلهبهمرحله
فصلها و بخشهای آموزشی را به ترتیب دنبال کنید، مطالب دیدهنشده را پیدا کنید و بدون سردرگمی به ادامه مسیر برگردید.
✓
تمرین و سنجش آموختهها
با نکتههای آموزشی، پرسش و پاسخ، کوییزها و آزمونهای پایان فصل، دانستههای خود را تمرین کنید و بخشهایی را که به توجه بیشتری نیاز دارند بشناسید.
SMART REVIEW
هر بار، مرور هدفمندتر
لازم نیست هر روز از ابتدا درباره اینکه چه چیزی را مرور کنید تصمیم بگیرید. سامانه، صف مرور روزانه را بر اساس کارتهای تازه و موعد مرور کارتها آماده میکند. شما پاسخ را ارزیابی میکنید و برنامه مرور با توجه به آن تنظیم میشود.
دوباره
برای کارتهایی که به تمرین زودتر نیاز دارند.
سخت
برای پاسخهایی که با دشواری به یاد آمدهاند.
خوب
برای پاسخهایی که بهدرستی به یاد آوردهاید.
آسان
برای کارتهایی که پاسخ آنها را بهآسانی میدانید.
برنامه مرور بر اساس ارزیابی شما تنظیم میشود؛ مرور منظم میتواند به تثبیت آموختهها کمک کند، اما بهتنهایی تضمینکننده تسلط کامل نیست.
محتوا را به شیوههای مختلف تمرین کنید
ساختار دورهها متناسب با موضوع آموزشی طراحی شده است و ممکن است انواع مختلفی از محتوا را در بر بگیرد.
نکتههای ساده
برای مرور سریع مفاهیم اصلی و نکات کلیدی.
نکتههای رسمی
برای تمرین تعاریف، اصطلاحات و بیان دقیق علمی.
کوییز
برای سنجش درک مطلب و بررسی گزینه صحیح.
پرسش و پاسخ
برای تمرین یادآوری و سنجش میزان تسلط بر مطالب.
محتوای هر دوره بر اساس ساختار و امکانات فعال همان دوره ارائه میشود.
LEARN ANYWHERE
همراه شما روی مرورگر
برای استفاده از نسخه تحت وب، کافی است با حساب کاربری خود وارد سامانه شوید. بدون نیاز به نصب یک برنامه اختصاصی، میتوانید از مرورگر سازگار روی گوشی، تبلت یا رایانه به دورههای در دسترس خود مراجعه کنید.
گوشی هوشمند
برای مطالعه در زمانهای کوتاه
تبلت و لپتاپ
برای مطالعه و مرور راحتتر
حساب کاربری شخصی
برای دسترسی به دورههای مجاز شما
COURSE COMPLETION CERTIFICATE
گواهی پایان دوره؛ ثبت دستاورد شما
در دورههایی که امکان دریافت گواهی برای آنها فعال است، میتوانید پس از تکمیل شرایط آموزشی، درخواست گواهی پایان دوره ثبت کنید.
شرایط درخواست گواهی
✓ داشتن دسترسی دارای قابلیت گواهی برای دوره مربوطه.
✓ تکمیل اطلاعات لازم در پروفایل، شامل کد ملی معتبر، عکس پرسنلی و نام و نام خانوادگی انگلیسی.
✓ مشاهده تمام فلشکارتهای فعال دوره.
✓ قبولی در آزمونهای پایان فصل، در صورت وجود آزمون برای فصلها.
فارسی و انگلیسی
پس از تأیید و انتشار، نسخههای فارسی و انگلیسی گواهی در دسترس قرار میگیرند.
استعلام آنلاین
گواهی منتشرشده دارای QR Code و لینک اختصاصی برای بررسی آنلاین اعتبار آن است.
دانلود و چاپ
پس از انتشار گواهی، امکان دریافت نسخه PDF فارسی و انگلیسی و چاپ آن فراهم است.
توجه: ثبت درخواست به معنای صدور قطعی نیست. درخواست گواهی پس از بررسی و تأیید ادمین منتشر میشود. این گواهی، گواهی پایان دوره آموزشی است و بهخودیخود معادل مدرک دانشگاهی یا مدرک رسمی مورد تأیید نهادهای دولتی نیست.
یادگیری را شروع کنید؛ پیشرفت را دنبال کنید
با تمرین منظم، مرور هدفمند و پیگیری مسیر آموزشی خود، قدمبهقدم دانش و مهارتهایتان را گسترش دهید.
هر کارت، یک قدم به جلو
امکانات محتوایی، مرور و گواهی بر اساس سطح دسترسی و تنظیمات هر دوره متفاوت است.
نگاهی به محیط سامانه
یادگیری هوشمند، قدمبهقدم
با محیط سامانه آموزشی آشنا شوید و نمونههایی از فضای یادگیری، فلشکارتها و ابزارهای مرور و تمرین را مشاهده کنید.
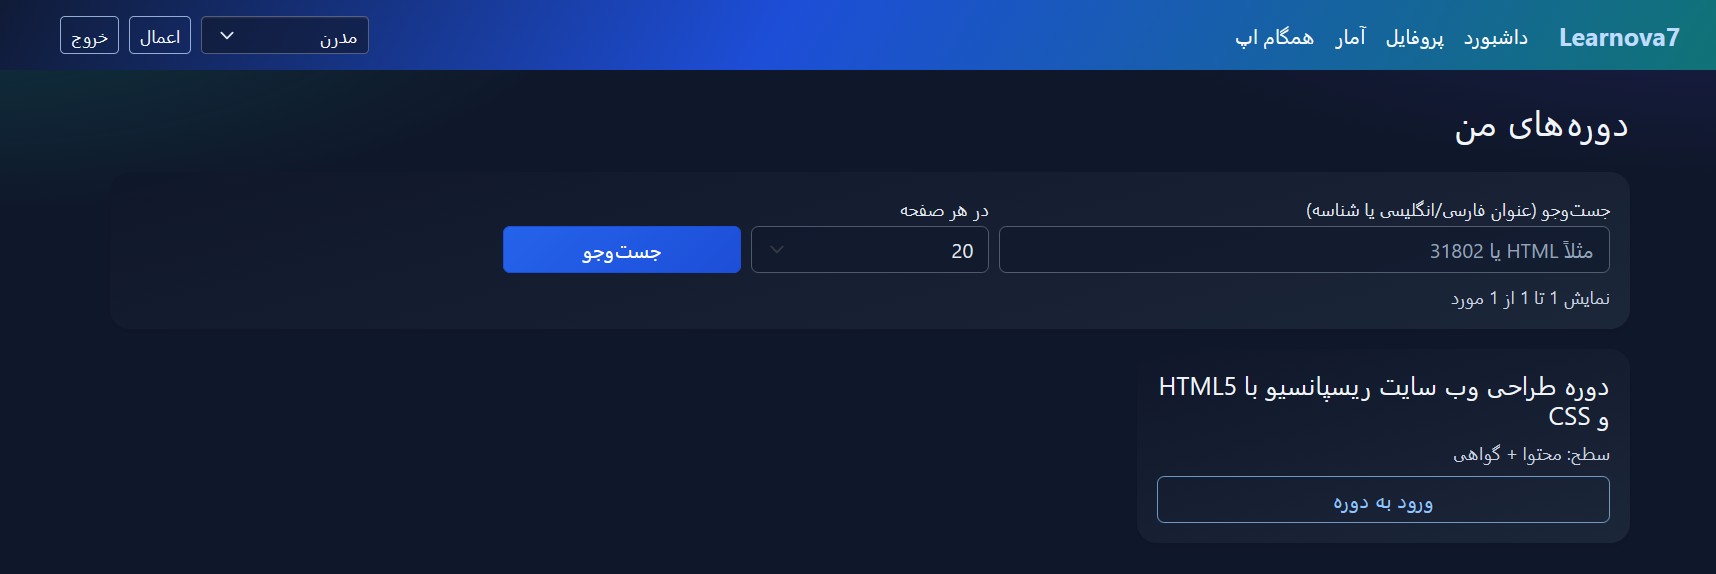
محیط سامانه آموزشی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
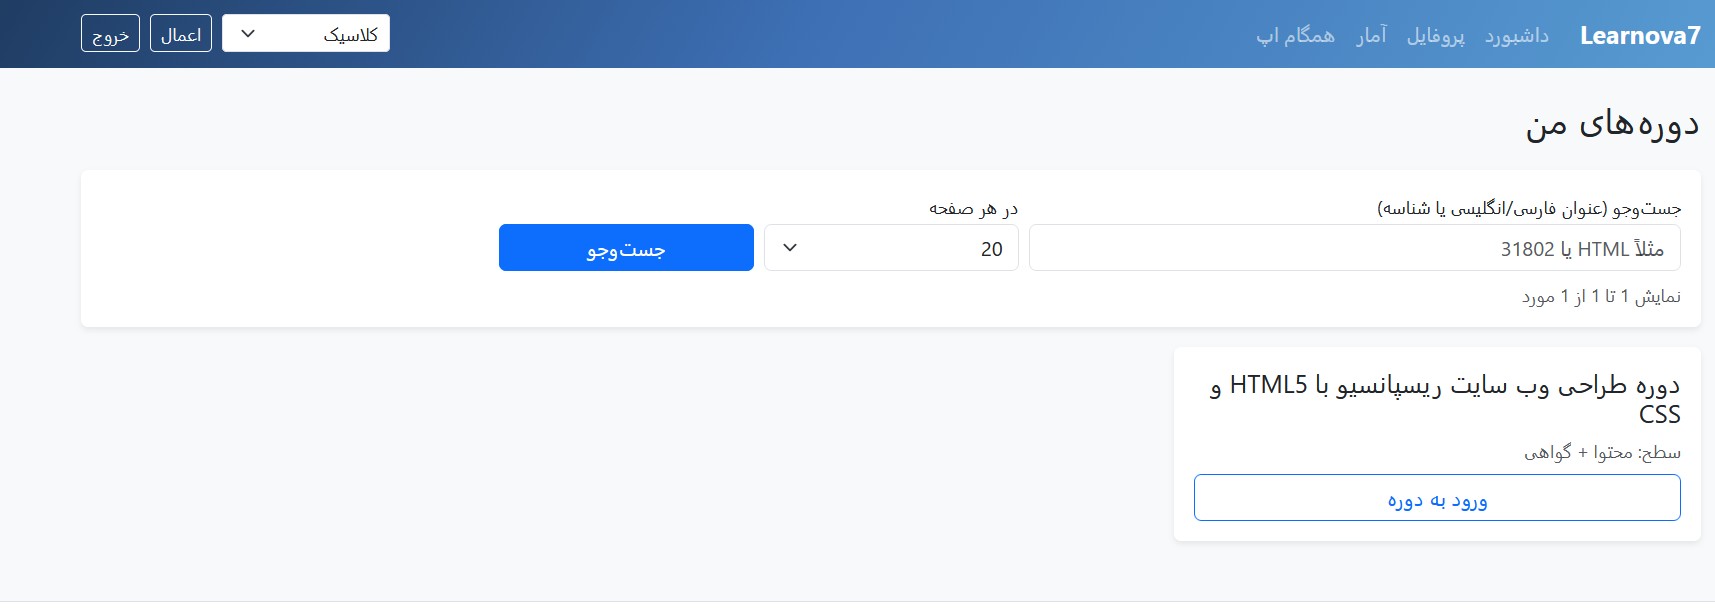
یادگیری و مرور مطالب
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
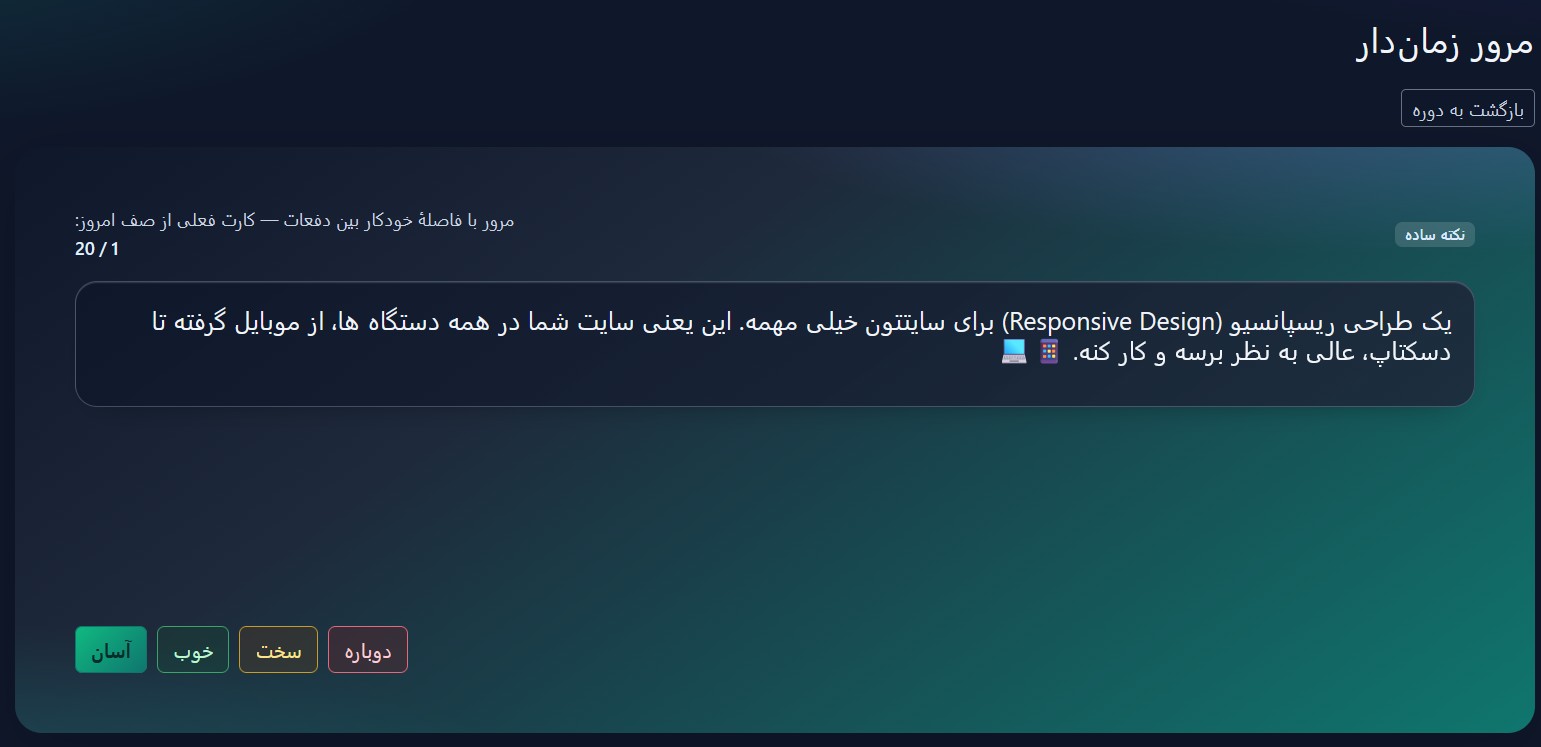
تجربه مطالعه تعاملی
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
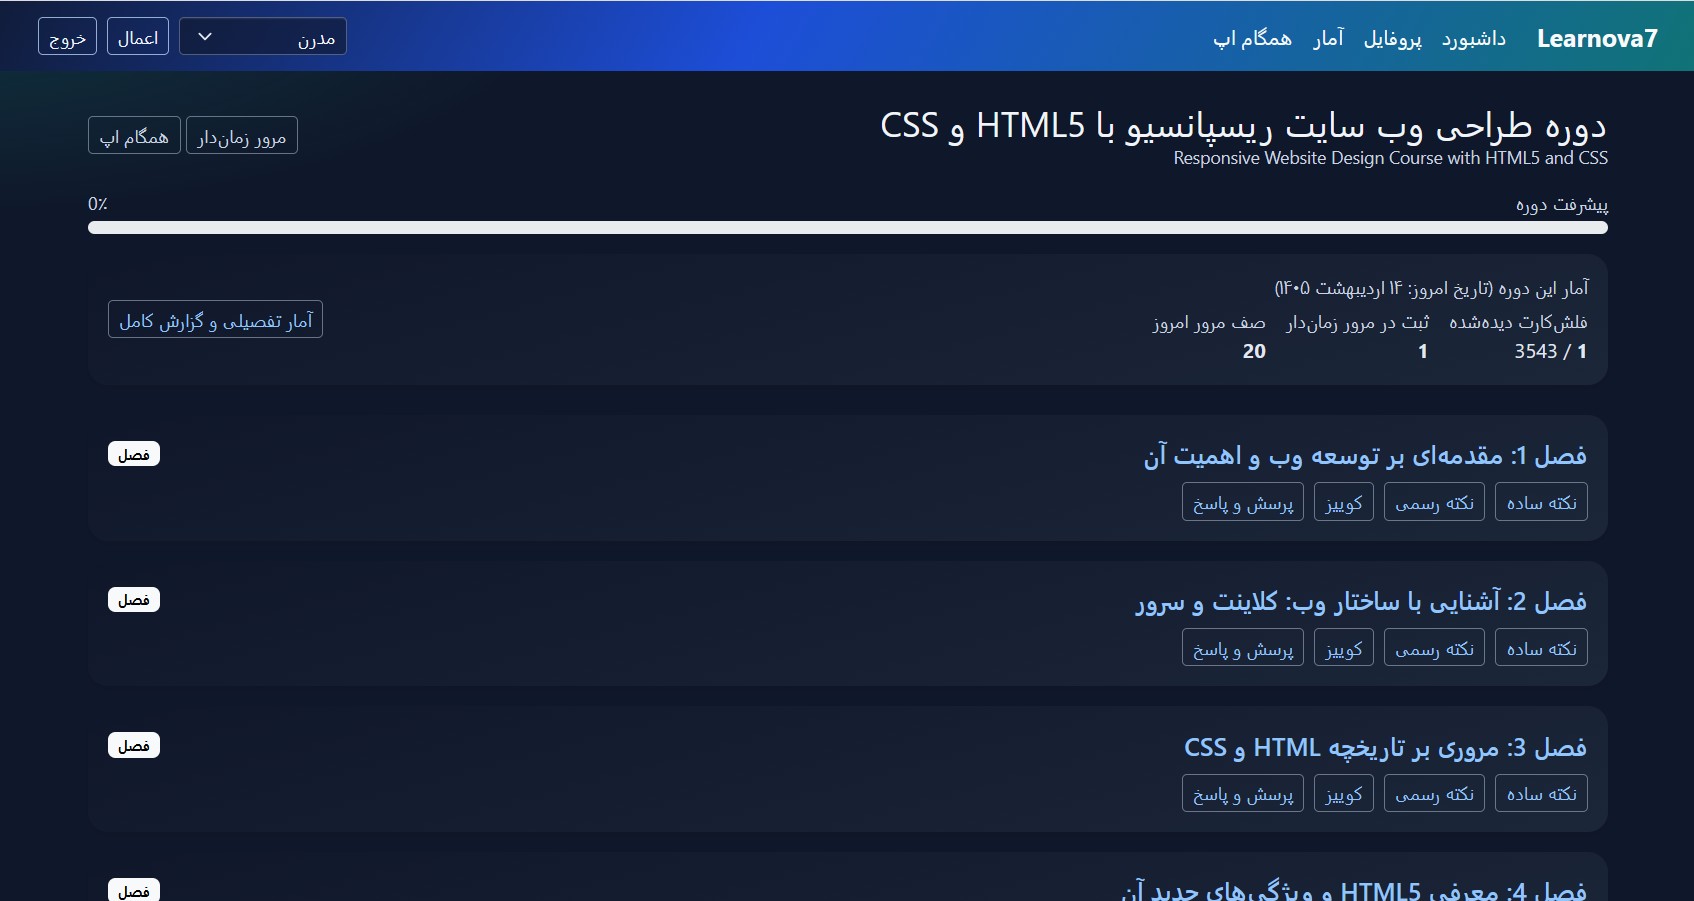
امکانات بیشتر سامانه
برای مشاهده تصویر در اندازه بزرگتر کلیک کنید
یادگیری فراتر از مطالعه معمولی
با فلشکارتهای آموزشی، مرور هدفمند و تمرین مستمر، مطالب را فعالانه یاد بگیرید و مسیر پیشرفت خود را دنبال کنید.
تگها:
Closed-Form Solutions
Linear Systems
LQR
MDP خطی
Optimal Control
reinforcement learning
سیستمهای خطی
سیستمهای دینامیکی
کنترل بهینه
کنترل تطبیقی
مقالات علمی
هوش مصنوعی در کنترل
هوشمند سازی
یادگیری تقویتی
یادگیری ماشین
نظرات
هنوز نظری ثبت نشده است.
وارد شوید تا نظر ثبت کنید.